Diviser pour régner, tris rapides
Diviser pour régner, tris rapides
Frédéric Herbreteau, Bordeaux INP/LaBRI (frederic.herbreteau@bordeaux-inp.fr)
Fusionner des tableaux triés
- PRECOND:
aetbsont deux tableaux d’entiers triés - POSTCOND: le tableau retourné est la fusion triée de
aetb
def merge_sorted_arrays(a: IntArray, b: IntArray) -> IntArray:
- quelle est la complexité en temps et en espace de cet algorithme?
Diviser pour régner
Principe: résoudre un gros problème en le découpant en plus petits problèmes et en resolvant ceux-ci
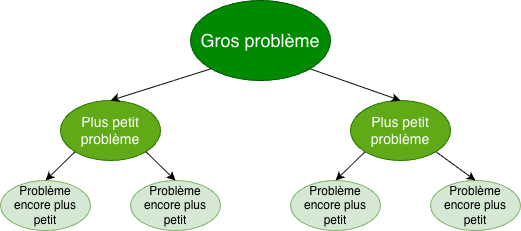
- découpage en un nombre constant de sous problèmes, plus petits ou plus simples
- donne naturellement un schéma récursif pour résoudre le problème
Application au tri d’un tableau d’entiers
Principe: étant donné un tableau t
- diviser
ten ses deux moitiésaetb - trier
aetb: problèmes plus petits - fusionner les tableaux triés avec
merge_sorted_arrays
def naiveMergeSort(t: IntArray) -> IntArray:
- prouver terminaison et correction de la fonction
naiveMergeSort - comment déterminer la complexité de cet algorithme?
Complexité: résolution des récurrences de partitions
Récurrence de partition des problèmes
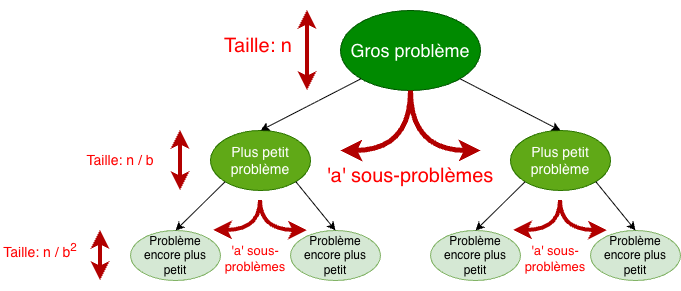
Définition: Une équation de récurrence de partitions est de la forme:
$T(n) = a \cdot T\left(\frac{n}{b}\right) + f(n)$
où $n \in \mathbb{N}$, $a$ et $b$ sont deux constantes entières telles que $a \geq 1$ et $b > 1$ et $f$ est une fonction de $\mathbb{N}$ dans $\mathbb{R}_+$.
Théorème principal (cas où $f$ est polynomialement bornée)
Si $f$ majorée par un polynôme de degré $d \in \mathbb{N}$, c’est à dire $f(n) \in \Omicron(n^d)$, on a:
\[T(n) = a \cdot T\left(\frac{n}{b}\right) + \Omicron(n^d)\]Théorème général (Master theorem): pour tout $a \ge 1$, $b > 1$ et $d \in \mathbb{N}$:
- si $d < \log_b(a)$ alors $T(n) \in \Omicron(n^{\log_b(a)})$
- si $d = \log_b(a)$ alors $T(n) \in \Omicron(n^d \cdot \log_b(n))$
- si $d > \log_b(a)$ alors $T(n) \in \Omicron(n^d)$
Complexité de naiveMergeSort
Complexité temporelle (pire et moyenne)
- diviser: $2$ sous-problèmes de taille $\frac{n}{2}$
merge_sorted_arraysest $\Omicron(n)$
Complexité spatiale
- sur une branche, taille cumulée des tableaux
aetballoués: $n + \frac{n}{2} + \frac{n}{4} + \ldots \le 2n$ - un seul tableau
cen mémoire de taille $\le n$ - pile de récursion en $\Omicron(\log_2(n))$
Tris efficaces
Tri fusion (merge sort, John von Neumann 1945)
Principe: similaire à naiveMergeSort, mais en évitant d’allouer 3 tableaux à chaque appel
- chaque appel à
naiveMergeSortn’utilise qu’une partie du tableaut - les tableaux
aetbsont inutiles: il suffit de mémoriser la partie detconsidérée lors de l’appel - un unique 2ème tableau suffit à fusionner efficacement en alternant les tableaux
def mergeSort(t: IntArray) -> None:
L’algorithme mergeSort est $\Omicron(n \cdot \log_2(n))$ en temps au pire et en moyenne, et $\Omicron(n)$ en espace, mais avec une seule allocation.
Tri rapide (quicksort, Tony Hoare 1959)
Principe: “diviser pour régner”
- choisir un pivot
pparmi les éléments det - diviser
ten trois parties:< p,= pet> p - trier récursivement les deux parties
< pet> p
def recQuickSort(t: IntArray, begin: int, end: int) -> None:
    if end - begin <= 1:
      return
    p = t[random.randint(begin, end-1)]  # choix aléatoire du pivot
    lt, gt = partition(t, begin, end, p)
    recQuickSort(t, begin, lt)
    recQuickSort(t, gt, end)
- complexité en temps: $\Omicron(n^2)$ au pire, et $\Omicron(n \cdot \log_2(n))$ en moyenne; et en espace auxiliaire $\Omicron(1)$, en espace total: $\Omicron(n)$ au pire, $\Omicron(\log_2(n))$ en moyenne
Partition (dutch national flag problem, Edsger Dijkstra)
def partition(t: IntArray, begin: int, end: int, pivot: int) -> Tuple[int, int]:
Principe:
- 3 indices
l,gd’une part, etid’autre part pour parcourir le tableau - invariants:
- les entiers dans
t[begin..l]sont< pivot - les entiers de
t[l..i]sont= pivot - ceux de
t[i..g+1]doivent encore être considérés - les entiers de
t[g+1..end]sont> pivot
- les entiers dans
Complexité en temps: $\Omicron(end-begin)$ et en espace $\Omicron(1)$